넥스트폼은 실제 도시를 디지털트윈으로 구현하고, 자율주행 AI 학습 데이터를 생성합니다.
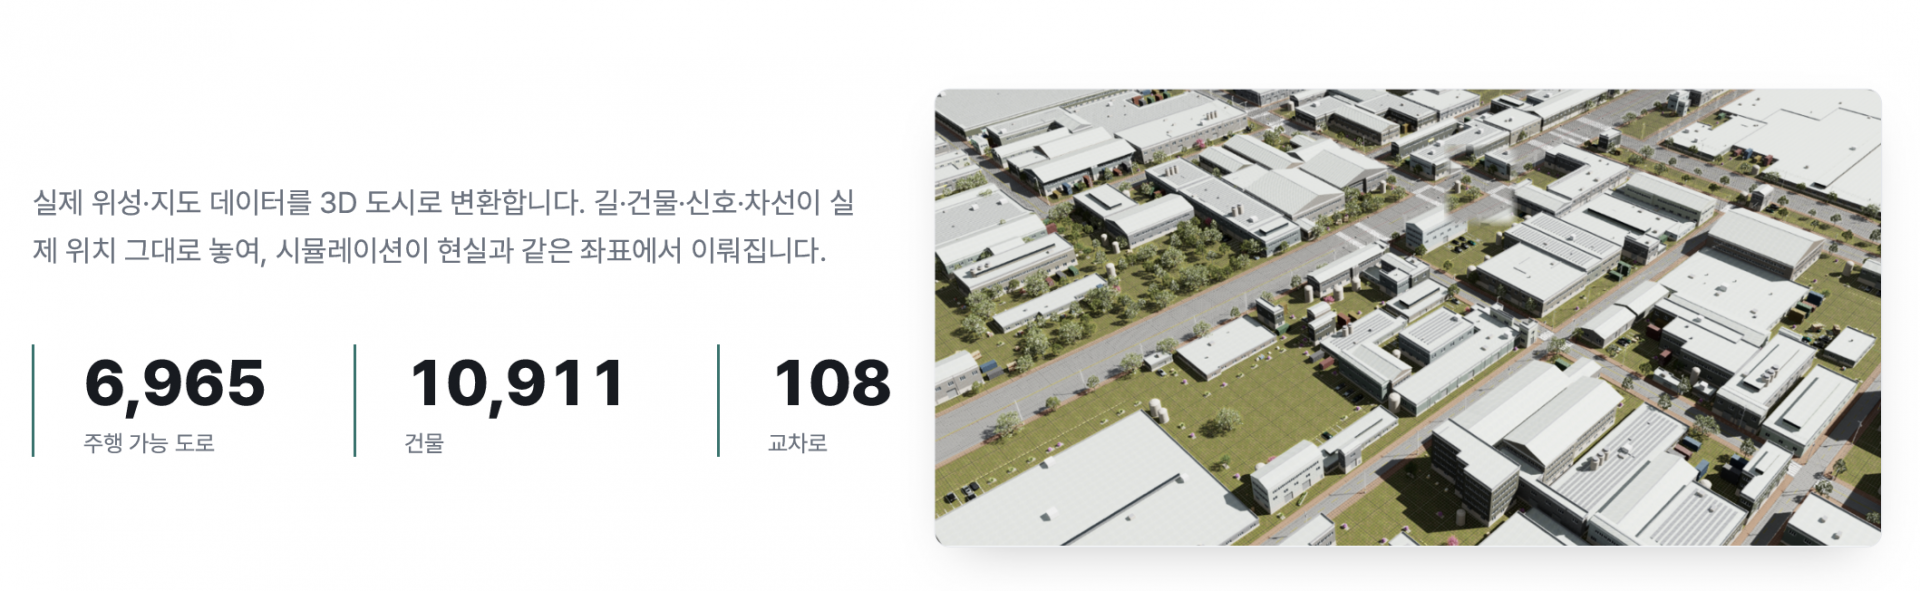
구미 1국가산업단지를 대상으로 실제 도시 환경을 가상 공간에 구현하고, 자율주행 AI 학습에 필요한 합성데이터를 생성할 수 있는 디지털트윈 기반 플랫폼을 구축했습니다.
실제 지도와 공간정보를 기반으로 도로·건물·교차로·신호체계 등을 3D 환경으로 구현하고, 가상 차량이 해당 공간을 주행하면서 Camera, LiDAR, Depth, Semantic Segmentation 등 다양한 센서 데이터를 동시에 생성할 수 있도록 구성했습니다.
또한 차량·보행자·신호등의 위치와 상태를 기반으로 2D/3D Bounding Box, Semantic Segmentation, Depth 등 AI 학습용 정답 데이터를 자동 생성하여 별도의 수작업 라벨링 부담을 줄였습니다.
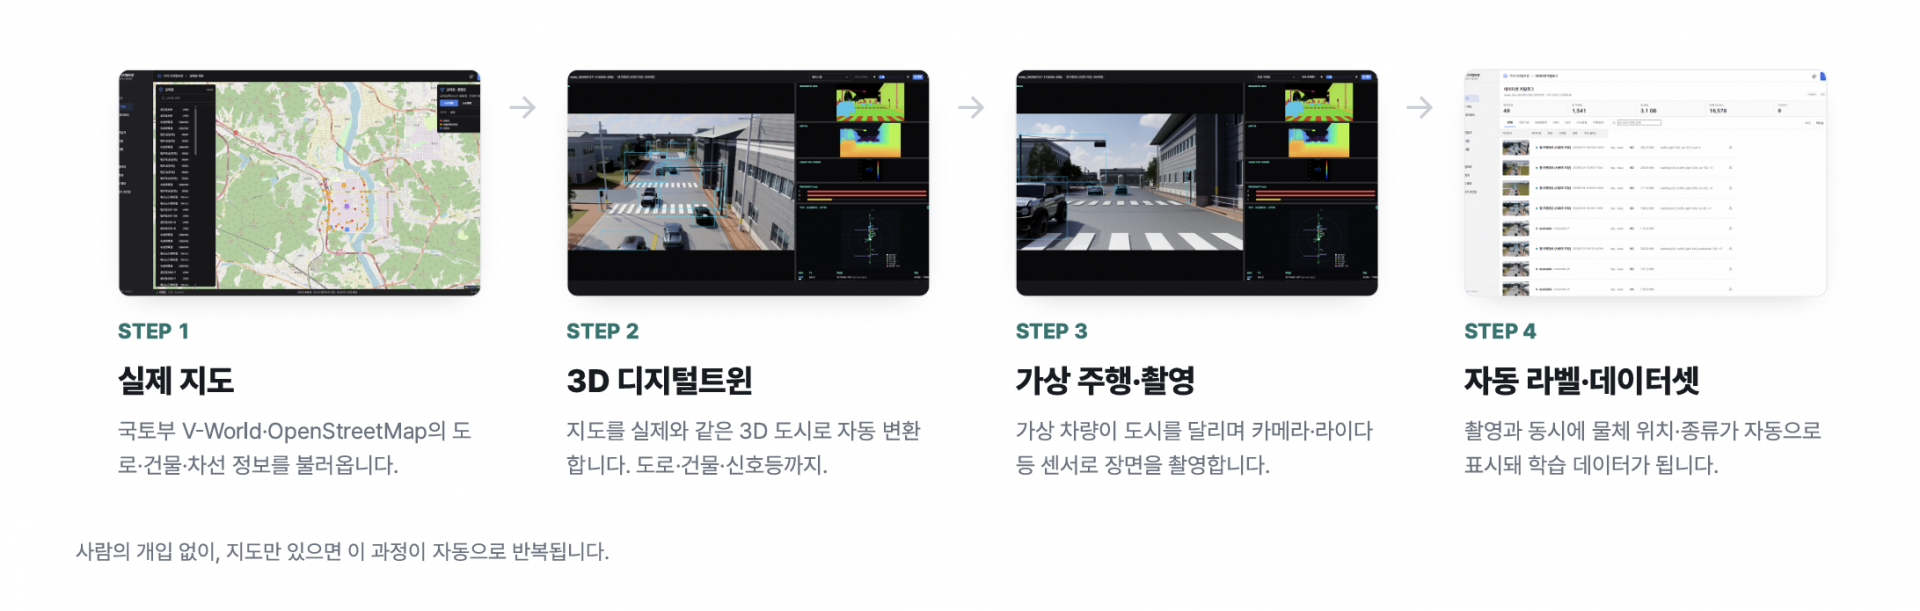
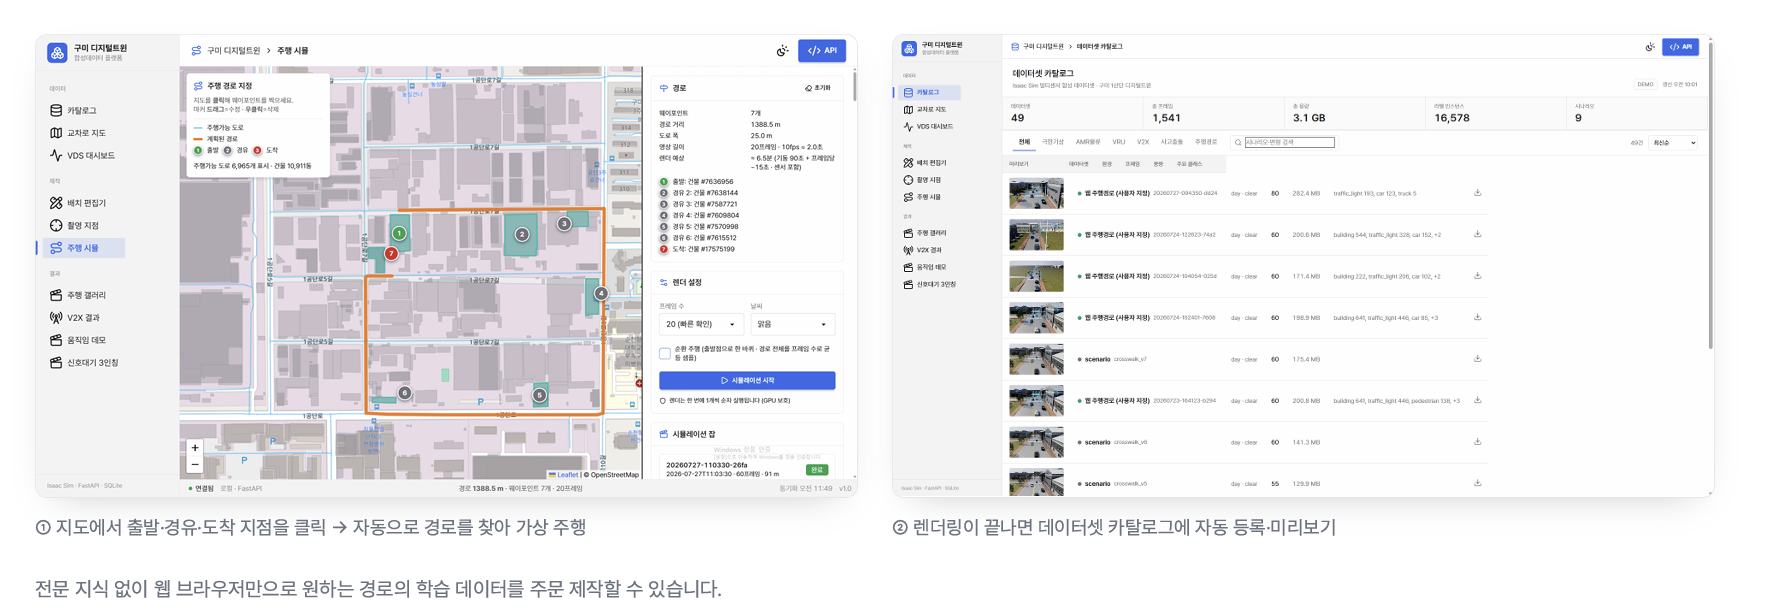
웹 플랫폼을 통해 출발지·경유지·목적지를 지정하면 주행 경로 생성부터 시뮬레이션, 센서 데이터 생성, 자동 라벨링, 데이터셋 관리까지 하나의 환경에서 수행할 수 있습니다.
✅ 왜 가상 데이터가 필요할까요?
자율주행 AI는 수백만 장의 “정답이 달린” 주행 영상을 보며 배웁니다. 그런데 이 데이터를 실제 도로에서 모으는 데는 큰 벽이 있습니다.
- 비용과 시간 — 차량·장비·사람이 실제 도로를 수개월 돌아야 합니다.
- 위험한 상황 — 사고 직전, 무단횡단 같은 장면은 실제로 찍을 수 없습니다.
- 손으로 하는 라벨링 — 영상 속 차·사람을 사람이 일일이 표시해야 합니다.
→ 가상 도시에서는 이 세 가지를 모두 해결합니다. 위험 상황도 안전하게, 라벨은 자동으로, 원하는 만큼.
✅ 지도 한 장에서 학습 데이터까지, 네 단계
✅ 구미 1산단을 그대로 복제했습니다
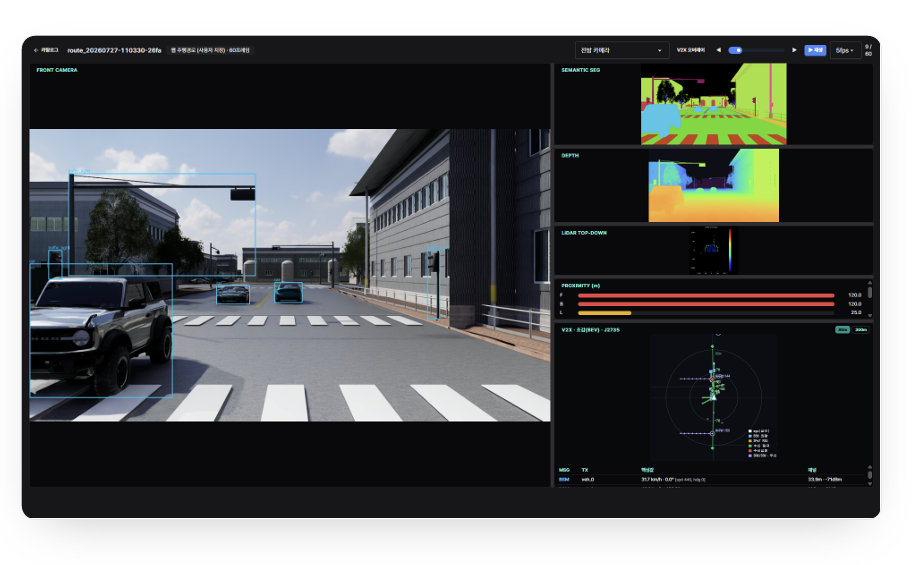
✅ 한 번 달리면 여러 센서가 동시에 찍습니다.
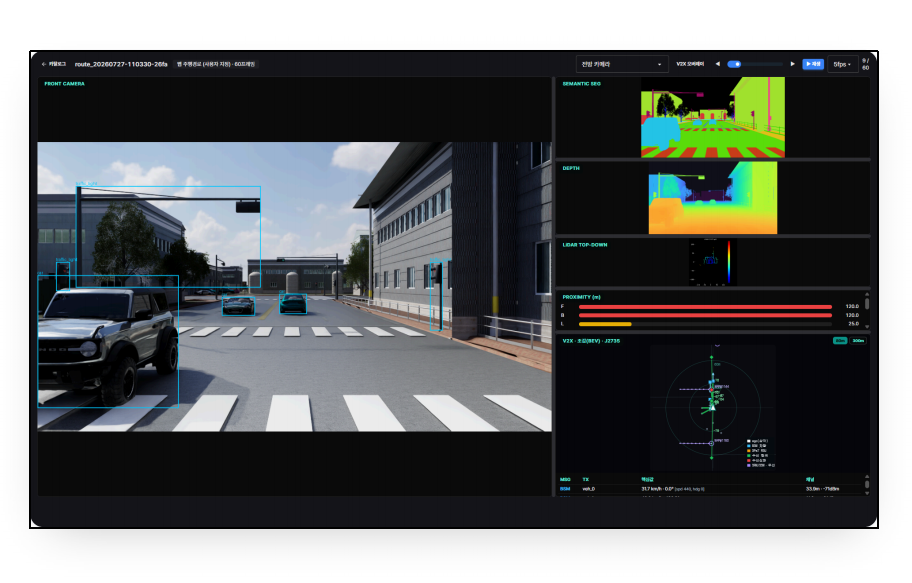
| 실제 자율주행차에 달린 센서 구성을 그대로 재현합니다. - 카메라 — 차량 전방과 3인칭 시점의 실사 영상
- 라이다(LiDAR) — 주변을 3차원 점으로 스캔
- 깊이·의미분할 — 거리 지도와 “무엇이 어디에” 색칠 지도
- 근접·레이더 — 주변 물체까지의 거리 감지
실제 자율주행차에 달린 센서 구성을 그대로 재현합니다.
|
✅ 정답표는 자동으로 붙습니다.
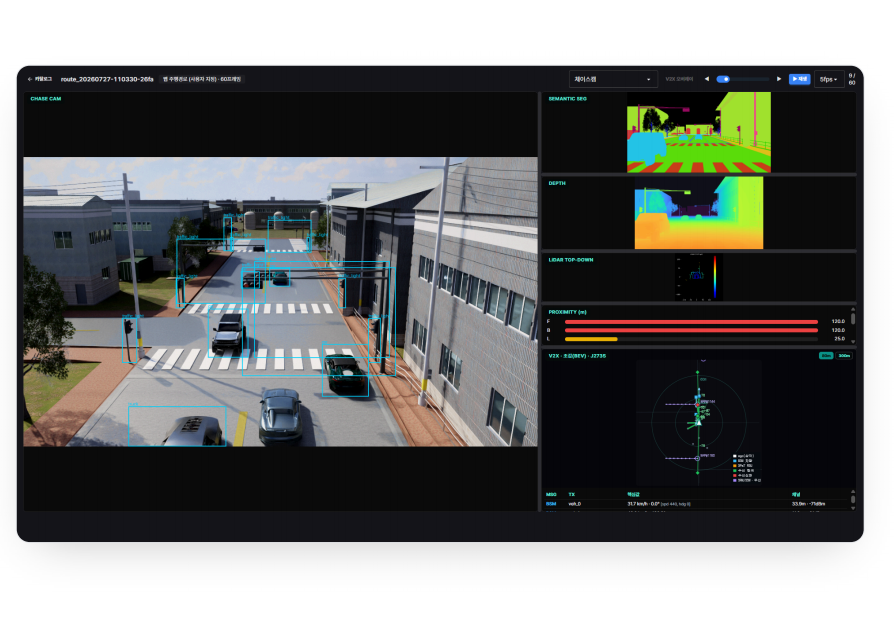
| 가상 세계는 차·사람·신호가 “어디에 무엇이” 있는지 이미 알고 있습니다.
그래서 사람이 일일이 표시하지 않아도 라벨이 정확히 자동으로 생성됩니다. - 물체를 감싸는 2D·3D 상자(bbox)
- 픽셀 단위 의미 분할과 거리(깊이)
- 먼 물체·건물은 자동 제외해 깔끔한 라벨 유지
|
✅ 신호를 지키고, 사람이 건너고, 차가 스스로 달립니다!
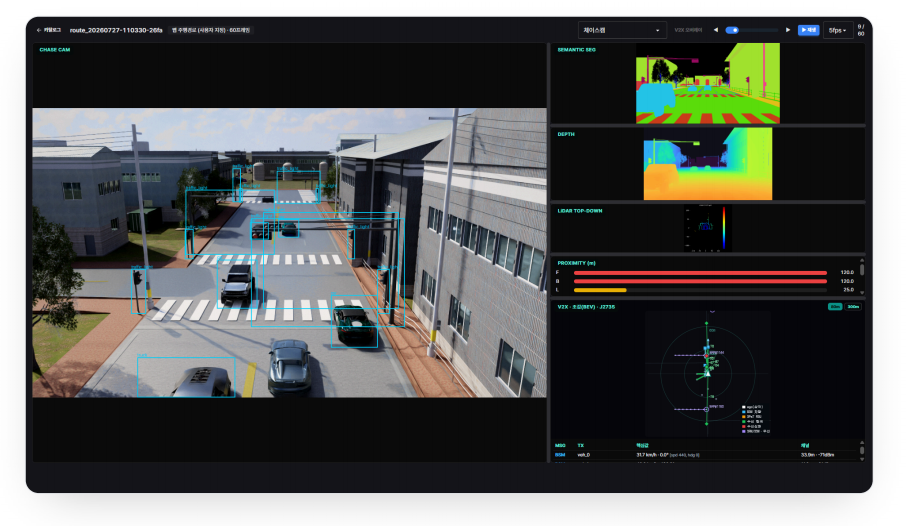
- 하나의 신호 주기로 통제 — 신호등 현시·잔여시간을 단일 상태기계로 두고, 모든 차·보행자·정지선이 이 신호에 맞춰 반응합니다.
- 보행자 신호 연동 — 차량이 적신호일 때만 횡단을 시작하고, 다 건너면 인도를 따라 계속 걸어갑니다.
- 배경 차량 자율주행 — 정해진 길이 아니라 도로망 그래프를 따라 스스로 경로를 골라 달리며, 신호와 앞차 안전거리를 지킵니다.
- 물리 기반 부드러운 정지 — 급정거 없이 감속도 변화(저크)를 제한해, 정지선 앞 3m에 자연스럽게 멈춥니다.
✅ 차·신호·사람이 주고받는 신호도 기록합니다.
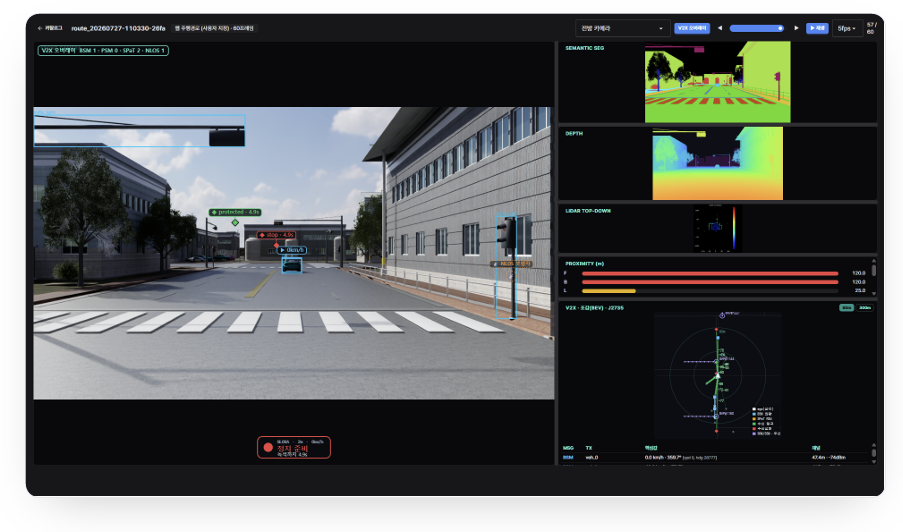
| 차량·신호등·보행자가 실시간으로 위치·상태를 무선으로 주고받는 통신을 국제표준(SAE J2735)으로 함께 기록합니다. 화면 속 각 물체에 뜬 배지가 실제 수신된 메시지입니다. - BSM · SPaT · PSM — 차량 위치·속도, 신호 현시·잔여시간, 보행자 정보를 실시간 수신
- NLOS 감지 — 건물에 가려 카메라로 안 보이는 상대도 통신으로 포착 (📡 점선 마커)
- GLOSA 판단 — 받은 신호로 통과·감속·정지를 권고 (정지 준비 · 녹색까지 4.9s)
단순 “데이터 기록”을 넘어, 카메라가 못 보는 것을 통신으로 메우고 그 정보로 판단하는 차세대 협력주행(C-ITS)까지 재현합니다.
|
✅ 지도에 목적지만 찍으면 데이터가 만들어집니다.
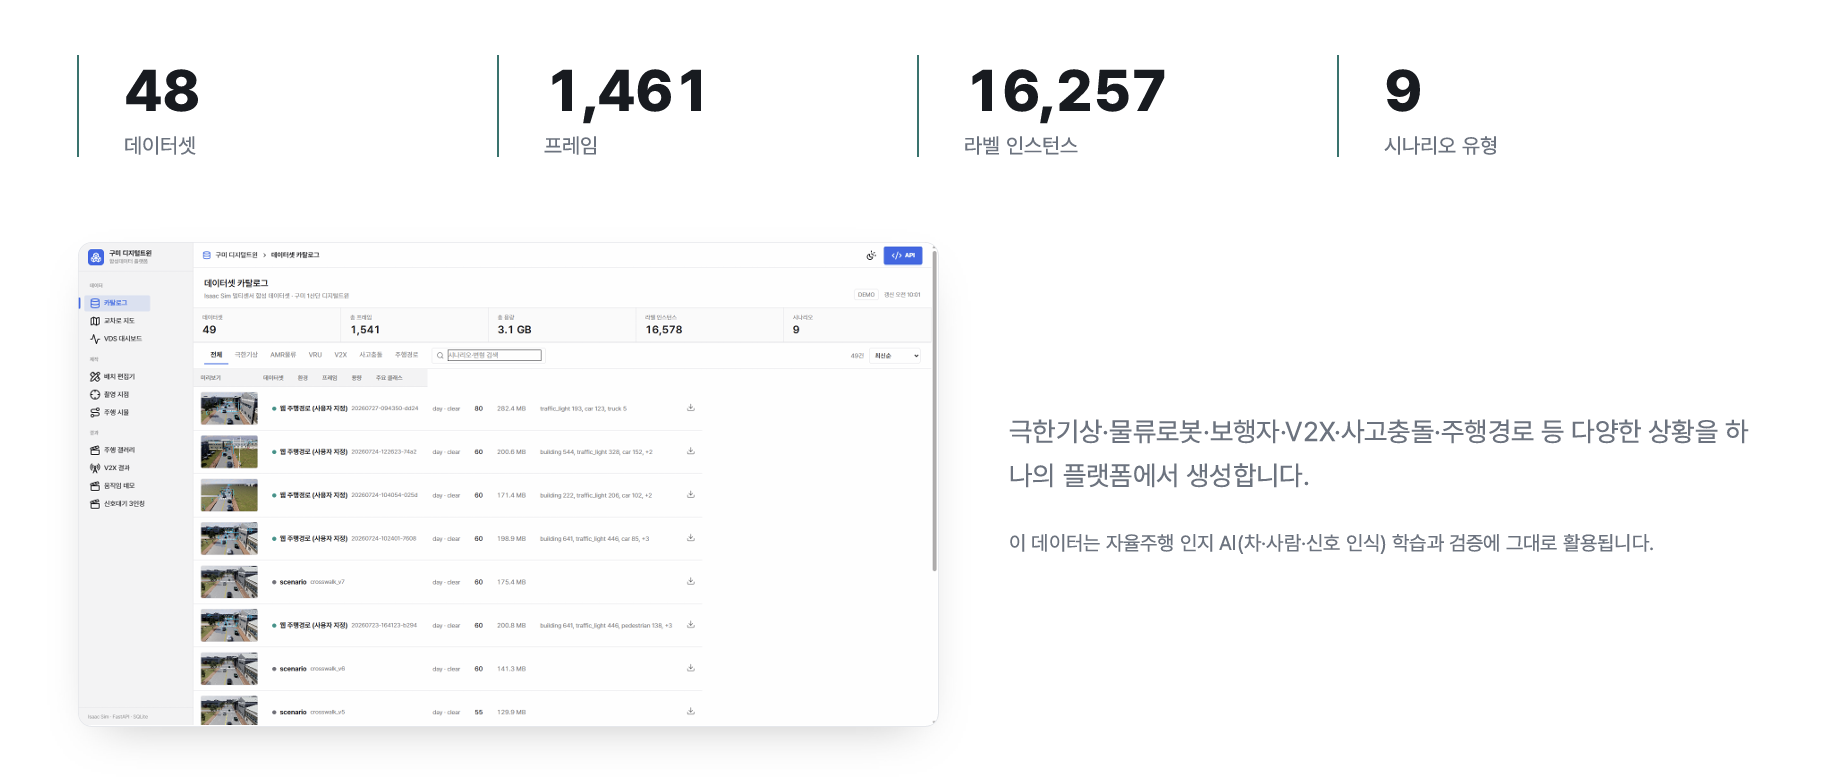
✅ 지금까지 만든 데이터



넥스트폼은 실제 도시를 디지털트윈으로 구현하고, 자율주행 AI 학습 데이터를 생성합니다.
구미 1국가산업단지를 대상으로 실제 도시 환경을 가상 공간에 구현하고, 자율주행 AI 학습에 필요한 합성데이터를 생성할 수 있는 디지털트윈 기반 플랫폼을 구축했습니다.
실제 지도와 공간정보를 기반으로 도로·건물·교차로·신호체계 등을 3D 환경으로 구현하고, 가상 차량이 해당 공간을 주행하면서 Camera, LiDAR, Depth, Semantic Segmentation 등 다양한 센서 데이터를 동시에 생성할 수 있도록 구성했습니다.
또한 차량·보행자·신호등의 위치와 상태를 기반으로 2D/3D Bounding Box, Semantic Segmentation, Depth 등 AI 학습용 정답 데이터를 자동 생성하여 별도의 수작업 라벨링 부담을 줄였습니다.
웹 플랫폼을 통해 출발지·경유지·목적지를 지정하면 주행 경로 생성부터 시뮬레이션, 센서 데이터 생성, 자동 라벨링, 데이터셋 관리까지 하나의 환경에서 수행할 수 있습니다.
✅ 왜 가상 데이터가 필요할까요?
자율주행 AI는 수백만 장의 “정답이 달린” 주행 영상을 보며 배웁니다. 그런데 이 데이터를 실제 도로에서 모으는 데는 큰 벽이 있습니다.
→ 가상 도시에서는 이 세 가지를 모두 해결합니다. 위험 상황도 안전하게, 라벨은 자동으로, 원하는 만큼.
✅ 지도 한 장에서 학습 데이터까지, 네 단계
✅ 구미 1산단을 그대로 복제했습니다
✅ 한 번 달리면 여러 센서가 동시에 찍습니다.
실제 자율주행차에 달린 센서 구성을 그대로 재현합니다.
실제 자율주행차에 달린 센서 구성을 그대로 재현합니다.
✅ 정답표는 자동으로 붙습니다.
가상 세계는 차·사람·신호가 “어디에 무엇이” 있는지 이미 알고 있습니다.
그래서 사람이 일일이 표시하지 않아도 라벨이 정확히 자동으로 생성됩니다.
✅ 신호를 지키고, 사람이 건너고, 차가 스스로 달립니다!
✅ 차·신호·사람이 주고받는 신호도 기록합니다.
차량·신호등·보행자가 실시간으로 위치·상태를 무선으로 주고받는 통신을 국제표준(SAE J2735)으로 함께 기록합니다.
화면 속 각 물체에 뜬 배지가 실제 수신된 메시지입니다.
단순 “데이터 기록”을 넘어, 카메라가 못 보는 것을 통신으로 메우고 그 정보로 판단하는 차세대 협력주행(C-ITS)까지 재현합니다.
✅ 지도에 목적지만 찍으면 데이터가 만들어집니다.
✅ 지금까지 만든 데이터